En lançant TorchNeuron, Amazon Web Services cherche à réduire l’un des principaux obstacles à l’adoption de ses processeurs Trainium : la dépendance des développeurs à l’écosystème logiciel de Nvidia. Derrière cette initiative technique se dessine une confrontation industrielle majeure, dans laquelle le contrôle des logiciels pourrait devenir aussi déterminant que la puissance des semi-conducteurs.
Atlas Limits | Technologie · Industrie · Intelligence artificielle | 20 octobre 2026
Introduction — La domination de Nvidia ne repose pas uniquement sur ses puces
Pendant plusieurs années, la compétition mondiale autour de l’intelligence artificielle a été présentée comme une course à la puissance de calcul.
Les entreprises technologiques ont multiplié les commandes de processeurs graphiques, les centres de données ont absorbé des investissements considérables et les gouvernements ont progressivement intégré les semi-conducteurs avancés à leurs stratégies de souveraineté industrielle.
Au centre de cette transformation s’est imposée une entreprise américaine : Nvidia.
Sa position dominante ne s’explique pourtant pas exclusivement par les performances de ses accélérateurs graphiques. Elle repose sur une architecture industrielle beaucoup plus profonde, associant processeurs, bibliothèques logicielles, outils de programmation, systèmes d’interconnexion et infrastructures de calcul.
Cette intégration constitue l’un des principaux avantages concurrentiels de Nvidia.
Une entreprise qui développe ses modèles d’intelligence artificielle dans cet environnement ne choisit pas simplement un fournisseur de matériel. Elle adopte progressivement un ensemble d’outils, de pratiques et d’optimisations qui rendent toute migration vers une architecture concurrente plus complexe.
C’est précisément cette dépendance qu’Amazon cherche aujourd’hui à réduire.
Avec TorchNeuron, Amazon Web Services (AWS) poursuit une ambition qui dépasse la commercialisation de ses processeurs Trainium : rendre ces derniers plus accessibles aux développeurs habitués à travailler avec PyTorch et, indirectement, avec les infrastructures dominées par Nvidia.
L’enjeu est considérable.
Si les entreprises peuvent déplacer leurs applications d’intelligence artificielle d’une architecture matérielle à une autre sans engager des opérations coûteuses de réécriture, une partie de la puissance économique de Nvidia pourrait être remise en question.
La bataille de l’intelligence artificielle entrerait alors dans une nouvelle phase : celle de la contestation du verrouillage logiciel.
I. Nvidia : une domination construite sur plusieurs décennies
Pour comprendre la portée de l’initiative d’Amazon, il faut revenir aux fondements de la puissance industrielle de Nvidia.
À l’origine, les processeurs graphiques ont été conçus pour accélérer le rendu des images et les calculs nécessaires aux applications visuelles.
Leurs capacités de traitement parallèle les ont ensuite rendus particulièrement adaptés à d’autres catégories de calculs intensifs, notamment ceux utilisés dans l’apprentissage automatique.
Nvidia a compris relativement tôt que la commercialisation de processeurs performants ne suffirait pas à construire une position durable.
En 2006, l’entreprise a introduit CUDA, une plateforme permettant aux développeurs d’exploiter les capacités de calcul de ses GPU pour des applications ne relevant pas exclusivement du graphisme.
Cette décision a profondément modifié la trajectoire industrielle du groupe.
CUDA a progressivement constitué un environnement de programmation autour duquel se sont organisés des bibliothèques scientifiques, des outils d’optimisation, des frameworks et des compétences professionnelles.
Lorsque l’apprentissage profond a commencé à se développer à grande échelle, Nvidia disposait déjà d’une infrastructure logicielle particulièrement avancée.
Les chercheurs et les ingénieurs pouvaient ainsi exploiter des outils existants plutôt que reconstruire leurs environnements de calcul.
Cet avantage initial s’est renforcé avec le temps.
Chaque nouvelle génération de processeurs a bénéficié d’un environnement logiciel déjà largement adopté. Chaque nouvelle application a contribué, à son tour, à consolider l’attractivité de cet environnement.
Il en est résulté un mécanisme classique d’économie industrielle : des effets de réseau indirects.
Plus les développeurs utilisent une architecture, plus les outils qui l’accompagnent deviennent nombreux et performants. Plus ces outils se développent, plus l’architecture devient attractive.
La domination de Nvidia n’est donc pas seulement une question de performances techniques.
Elle constitue également une forme de dépendance technologique cumulative.
II. CUDA : le véritable rempart industriel de Nvidia
La puissance d’un processeur peut être mesurée à travers différents indicateurs : capacité de calcul, bande passante mémoire, consommation électrique ou efficacité énergétique.
Ces caractéristiques permettent de comparer les architectures matérielles.
Mais elles ne suffisent pas à déterminer le coût réel d’utilisation d’une infrastructure d’intelligence artificielle.
Une entreprise qui entraîne ou exploite un modèle doit également prendre en compte les compétences de ses équipes, la compatibilité des bibliothèques, la stabilité des environnements logiciels et les coûts de maintenance.
Un processeur concurrent peut présenter un prix inférieur ou une efficacité énergétique supérieure sans être économiquement préférable si son adoption exige plusieurs mois d’adaptation.
C’est ici que CUDA intervient comme une barrière à l’entrée.
Les développeurs ne travaillent pas nécessairement directement avec CUDA. Ils utilisent souvent des frameworks de plus haut niveau, comme PyTorch, qui s’appuient sur des bibliothèques et des mécanismes d’exécution optimisés pour les GPU Nvidia.
La dépendance est donc parfois indirecte, mais elle reste importante.
Elle apparaît notamment lorsque les applications utilisent des opérations personnalisées, des bibliothèques spécialisées, des noyaux de calcul optimisés ou des mécanismes de communication entre accélérateurs.
Le passage vers une architecture concurrente peut alors nécessiter de modifier certaines parties du code, de remplacer des composants logiciels et de revalider les performances du modèle.
Ces coûts de transition constituent un avantage économique majeur pour le fournisseur installé.
Ils permettent à Nvidia de défendre sa position même lorsque des concurrents proposent des accélérateurs techniquement compétitifs.
L’objectif d’Amazon est de réduire cette friction.
Il ne s’agit pas nécessairement de remplacer CUDA dans toutes ses fonctions, mais de diminuer le nombre de situations dans lesquelles la dépendance à cet environnement empêche l’adoption d’une autre architecture.
Cette distinction est fondamentale.
Une entreprise peut conserver son environnement de développement habituel tout en faisant fonctionner certaines charges de travail sur des processeurs différents.
Si cette possibilité devient suffisamment simple, fiable et économiquement intéressante, la relation entre logiciel et matériel pourrait évoluer.
III. TorchNeuron : Amazon attaque le coût de la migration
L’annonce de TorchNeuron s’inscrit dans cette logique.
AWS cherche à simplifier l’utilisation de ses accélérateurs Trainium par les développeurs travaillant avec PyTorch, l’un des principaux frameworks d’apprentissage automatique.
L’objectif est de limiter les adaptations nécessaires pour exécuter certaines applications sur l’infrastructure matérielle d’Amazon.
La portée de cette initiative tient moins à l’apparition d’un nouvel outil qu’au problème industriel qu’elle tente de résoudre.
Jusqu’à présent, les accélérateurs alternatifs aux GPU Nvidia se heurtaient fréquemment à une difficulté : leur adoption supposait des efforts d’intégration qui pouvaient neutraliser une partie de leurs avantages économiques.
En améliorant la compatibilité avec les pratiques de développement existantes, Amazon cherche à déplacer la décision d’achat.
La question ne serait plus uniquement de savoir si une entreprise peut techniquement migrer vers Trainium, mais si elle a un intérêt économique à le faire.
Cette évolution pourrait renforcer la concurrence sur plusieurs critères : coût par requête, débit de traitement, consommation énergétique, disponibilité des capacités et performance sur des modèles spécifiques.
AWS met notamment en avant l’expérience de Deepgram, spécialiste des technologies vocales, qui aurait obtenu, dans certaines configurations, une amélioration atteignant 70 % du volume audio traité par dollar dépensé après une migration vers Trainium.
Ce résultat illustre le potentiel économique de l’approche, mais il doit être interprété avec prudence.
Il concerne une application et une configuration particulières. Il ne démontre pas que Trainium serait systématiquement plus performant ou moins coûteux que les GPU Nvidia pour l’ensemble des charges de travail.
De même, la simplification de l’exécution d’un programme PyTorch ne signifie pas que toutes les opérations spécialisées deviennent automatiquement compatibles.
Les performances dépendent de nombreux facteurs : architecture du modèle, taille des lots de calcul, précision numérique, mémoire disponible, communications entre processeurs et maturité des compilateurs.
La véritable réussite de TorchNeuron devra donc être évaluée à partir de déploiements opérationnels suffisamment variés.
Néanmoins, l’orientation stratégique est claire.
Amazon cherche à faire disparaître une partie des obstacles logiciels qui protègent la position de Nvidia.
Et cette offensive intervient au moment où les coûts du calcul deviennent une question centrale pour l’économie de l’intelligence artificielle.
IV. Trainium : la volonté d’Amazon de contrôler sa propre infrastructure
La stratégie d’Amazon s’inscrit dans une transformation plus ancienne du secteur des infrastructures numériques.
Pendant longtemps, les grandes entreprises du cloud ont principalement acheté leurs processeurs auprès de fournisseurs spécialisés.
Intel et AMD dominaient les processeurs centraux, tandis que Nvidia s’imposait progressivement sur le marché des accélérateurs graphiques.
Cette organisation reposait sur une division relativement claire des responsabilités : les fabricants de semi-conducteurs concevaient les composants et les opérateurs cloud construisaient les infrastructures nécessaires à leur exploitation.
L’explosion des besoins en intelligence artificielle a progressivement remis en cause cet équilibre.
Les investissements consacrés aux accélérateurs sont devenus suffisamment importants pour justifier le développement de solutions propriétaires.
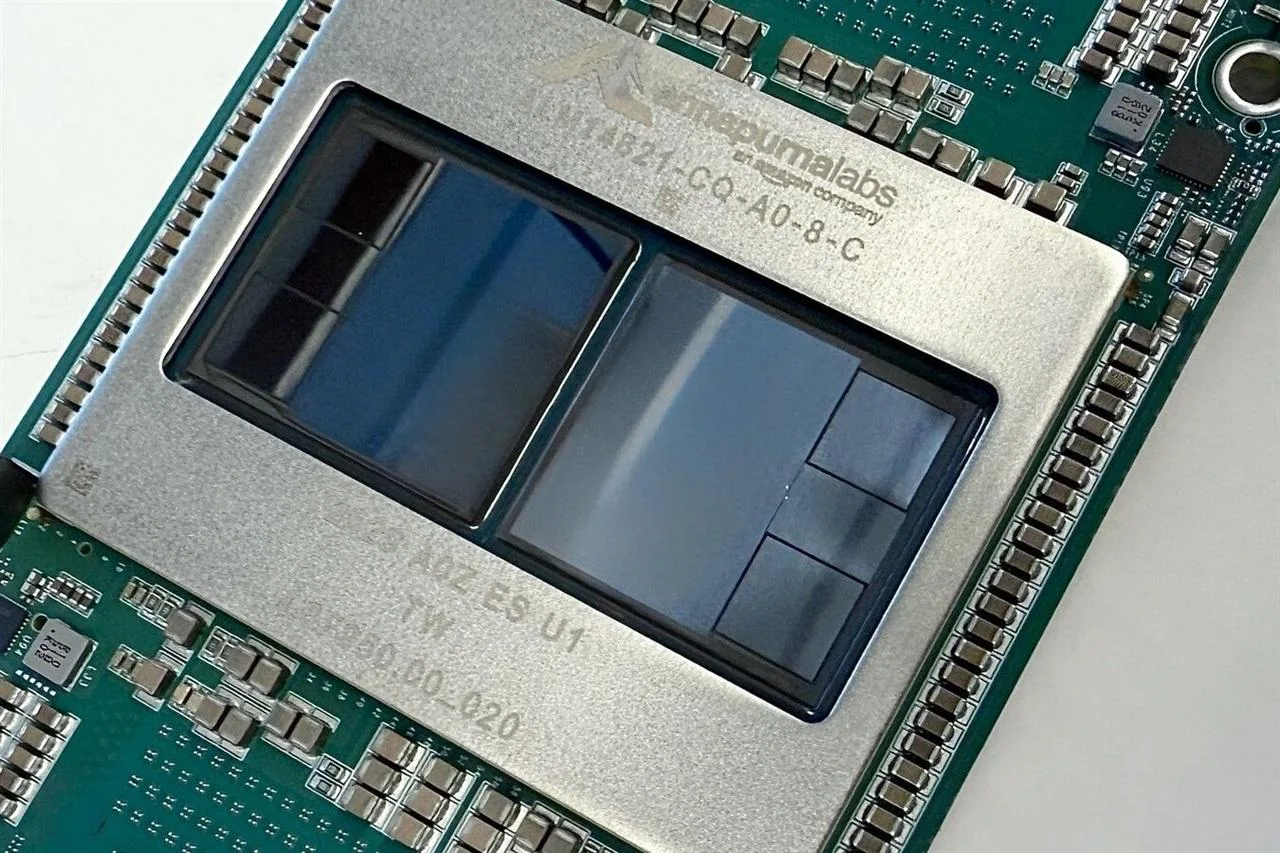
Amazon avait déjà engagé cette évolution avec l’acquisition d’Annapurna Labs en 2015.
Cette opération a contribué à constituer une capacité interne de conception de semi-conducteurs, aujourd’hui mobilisée dans plusieurs familles de processeurs.
Les puces Graviton répondent aux besoins de calcul généraliste, tandis que les familles Inferentia et Trainium ont été développées pour les applications d’intelligence artificielle.
Avec Trainium, Amazon cherche à maîtriser une part croissante de la chaîne technologique reliant le silicium aux services cloud.
L’entreprise peut concevoir des accélérateurs adaptés à ses besoins, les intégrer à ses centres de données, optimiser leur exploitation et proposer directement leur puissance de calcul à ses clients.
Cette intégration verticale présente plusieurs avantages potentiels.
Elle peut réduire l’exposition aux prix des fournisseurs externes, améliorer l’adéquation entre matériel et logiciel et permettre une optimisation économique à l’échelle des infrastructures.
Mais elle comporte également une difficulté majeure.
Un processeur propriétaire ne devient pas automatiquement une plateforme industrielle attractive.
Il doit pouvoir accueillir les applications que les développeurs souhaitent exécuter.
TorchNeuron apparaît donc comme un complément indispensable à la stratégie matérielle d’Amazon.
L’outil doit contribuer à transformer Trainium d’une solution spécialisée au sein d’AWS en une architecture plus accessible à l’ensemble des utilisateurs de PyTorch.
Le lancement sous licence open source Apache 2.0, annoncé en octobre 2026, renforce cette ambition. TorchNeuron prend en charge Trainium2 et Trainium3 et s’appuie sur les mécanismes d’extension matériels de PyTorch.
La dimension ouverte du logiciel mérite toutefois d’être distinguée de celle de l’infrastructure.
Le code de TorchNeuron peut être accessible et modifiable, tandis que les processeurs Trainium restent intégrés à l’environnement matériel et commercial d’AWS.
L’ouverture logicielle peut ainsi faciliter l’adoption d’une plateforme propriétaire.
Ce paradoxe apparent est au cœur de la stratégie.
V. La nouvelle économie de l’IA : le coût d’inférence devient décisif
L’économie de l’intelligence artificielle ne se limite plus à l’entraînement de modèles toujours plus puissants.
Une deuxième phase industrielle se développe : celle de leur exploitation à grande échelle.
L’entraînement correspond à la construction du modèle à partir de données et de calculs intensifs.
L’inférence désigne son utilisation opérationnelle, lorsqu’il génère du texte, analyse une image, traite un signal audio ou répond à une demande.
Ces deux activités présentent des structures économiques différentes.
L’entraînement mobilise généralement des ressources importantes sur des périodes relativement concentrées.
L’inférence peut, au contraire, générer une consommation continue de calcul, proportionnelle au nombre d’utilisateurs et à la complexité des requêtes.
Pour un service utilisé plusieurs millions de fois par jour, une réduction relativement modeste du coût unitaire peut produire des économies considérables.
Prenons une hypothèse illustrative.
Une entreprise traite quotidiennement 100 millions de requêtes d’intelligence artificielle, à un coût moyen de 0,01 dollar par requête.
Sa dépense annuelle théorique atteint 365 millions de dollars.
Une réduction de 25 % du coût unitaire représenterait alors une économie potentielle de 91,25 millions de dollars par an, à volume constant et hors coûts de migration.
Cet exemple ne constitue pas une estimation des performances de Trainium. Il permet simplement de mesurer la sensibilité économique des services d’IA à grande échelle.
Cette logique explique pourquoi la concurrence entre accélérateurs pourrait s’intensifier à mesure que l’IA devient une activité industrielle récurrente.
Pour les opérateurs de services, la performance absolue n’est pas toujours le critère dominant.
Le coût par unité de travail utile peut devenir plus important que la puissance maximale théorique.
Cette évolution favorise potentiellement les architectures spécialisées, optimisées pour certaines catégories de modèles ou certains types de calculs.
Mais elle ne garantit pas la victoire de ces architectures.
Un accélérateur économique sur une application particulière peut se révéler moins compétitif sur une autre.
La flexibilité, la disponibilité des bibliothèques et la facilité de déploiement conservent donc une valeur considérable.
C’est pourquoi l’offensive logicielle d’Amazon est aussi importante que ses investissements dans les processeurs.
Elle cherche à rendre l’arbitrage économique possible.
VI. Deepgram : une démonstration prometteuse, mais pas encore une preuve générale
L’expérience de Deepgram permet de mesurer à la fois l’intérêt et les limites de cette stratégie.
L’entreprise développe des technologies de traitement vocal, notamment de transcription et d’analyse audio.
Ces applications peuvent générer des volumes considérables de calcul, ce qui rend leur coût d’exploitation particulièrement sensible à l’efficacité des accélérateurs.
Selon une étude technique publiée par AWS le 19 octobre 2026, la migration du modèle Nova-3 vers Trainium2 a permis d’obtenir, sur certains traitements audio par lots, entre 11 % et 70 % de volume supplémentaire traité par dollar par rapport aux configurations précédemment utilisées.
Dans une déclaration publiée par PyTorch, le directeur technique de Deepgram évoque une amélioration d’environ 60 % dans les benchmarks évalués.
Ces chiffres correspondent à des périmètres de comparaison différents.
Il serait toutefois trompeur de présenter ces gains comme le résultat automatique d’un simple changement de configuration.
L’étude décrit plusieurs mois de travail, comprenant l’adaptation du modèle, l’optimisation de noyaux de calcul, l’analyse des performances et la mise au point d’un environnement d’exécution adapté.
Autrement dit, TorchNeuron peut faciliter la première étape de migration, mais l’obtention des meilleures performances peut encore nécessiter un travail d’ingénierie substantiel.
Cette distinction révèle le véritable défi d’Amazon.
La compatibilité fonctionnelle constitue une condition nécessaire.
La compétitivité économique durable dépendra de la capacité à reproduire ces résultats sur des modèles nombreux, complexes et continuellement renouvelés.
Pour les grandes entreprises, les décisions d’infrastructure reposent rarement sur un benchmark isolé.
Elles intègrent la fiabilité des systèmes, les coûts de développement, la disponibilité des équipements, les engagements contractuels et les risques associés à une dépendance technologique.
TorchNeuron réduit potentiellement l’une de ces contraintes.
Il ne les supprime pas toutes.
VII. Google, AMD et les autres concurrents : Nvidia face à une contestation collective
Amazon n’est pas la seule entreprise à vouloir réduire la dépendance de l’industrie aux accélérateurs Nvidia.
Google poursuit depuis plusieurs années le développement de ses Tensor Processing Units, ou TPU.
Ces processeurs spécialisés ont été conçus pour les opérations mathématiques utilisées dans l’apprentissage automatique.
Google dispose ainsi d’une capacité interne de conception matérielle et d’une plateforme cloud permettant leur commercialisation.
AMD, de son côté, cherche à développer une alternative sur le marché des accélérateurs avec sa gamme Instinct et son environnement logiciel ROCm.
La compétition porte donc simultanément sur le matériel et sur les outils permettant son exploitation.
D’autres entreprises explorent également des architectures spécialisées, adaptées à des charges de travail particulières.
Mais les stratégies concurrentes ne sont pas identiques.
AMD cherche principalement à proposer une alternative matérielle aux GPU Nvidia, avec une pile logicielle compatible avec les usages du calcul accéléré.
Google développe une architecture intégrée à ses propres infrastructures.
Amazon combine la conception de puces, la distribution cloud et l’amélioration de la compatibilité avec les frameworks utilisés par les développeurs.
Cette diversité est importante.
Elle montre que la contestation de Nvidia ne prend pas la forme d’un affrontement unique entre deux fabricants.
Elle résulte de la multiplication d’architectures concurrentes, soutenues par des entreprises disposant de ressources financières, techniques et commerciales considérables.
La concurrence pourrait donc devenir plus fragmentée.
Certains processeurs seraient privilégiés pour l’entraînement de modèles géants, d’autres pour l’inférence à grande échelle, d’autres encore pour des applications spécifiques.
La domination d’un fournisseur unique deviendrait moins évidente si les outils logiciels permettaient de répartir plus facilement les charges de travail entre plusieurs architectures.
Mais cette évolution dépend d’une condition : l’interopérabilité doit devenir suffisamment mature pour réduire les coûts de fragmentation.
Sans cela, l’industrie pourrait simplement remplacer une dépendance dominante par plusieurs environnements incompatibles.
VIII. Le paradoxe d’Amazon : libérer les développeurs de Nvidia pour les attirer vers AWS
L’offensive d’Amazon soulève une question fondamentale.
Une réduction de la dépendance à Nvidia signifie-t-elle nécessairement une augmentation de l’indépendance technologique des entreprises ?
Pas entièrement.
Amazon cherche à rendre les applications plus facilement transférables vers Trainium.
Mais ces processeurs sont proposés dans le cadre de son infrastructure cloud.
Une entreprise qui migre vers Trainium peut réduire sa dépendance au matériel Nvidia tout en renforçant sa dépendance commerciale à AWS.
Cette situation illustre une transformation plus large du secteur numérique.
Les fournisseurs cloud ne se contentent plus de louer des capacités informatiques.
Ils conçoivent les composants matériels, développent les environnements logiciels, organisent les réseaux, exploitent les centres de données et commercialisent les services associés.
La frontière entre fabricant de semi-conducteurs, opérateur d’infrastructure et fournisseur de plateformes devient de plus en plus difficile à distinguer.
Amazon peut ainsi concurrencer Nvidia sur une partie de son activité tout en continuant à proposer des instances utilisant ses processeurs.
Cette coexistence n’a rien de contradictoire.
Les clients d’AWS ont des besoins hétérogènes, et Amazon a intérêt à proposer plusieurs architectures afin de préserver l’attractivité globale de sa plateforme.
Son objectif n’est donc pas nécessairement d’éliminer Nvidia.
Il peut être plus rationnel de réduire la dépendance structurelle d’AWS à un fournisseur unique, de renforcer son pouvoir de négociation et de capter une plus grande part de la valeur créée par les infrastructures d’intelligence artificielle.
L’ouverture de TorchNeuron doit être analysée dans cette perspective.
Elle augmente potentiellement la liberté de choix entre architectures de calcul, sans garantir une liberté équivalente entre plateformes cloud.
La distinction entre portabilité logicielle et indépendance infrastructurelle devient alors essentielle.
IX. Nvidia conserve des avantages que TorchNeuron ne peut pas effacer immédiatement
Il serait prématuré de considérer cette annonce comme le début d’un recul inévitable de Nvidia.
L’entreprise dispose de plusieurs avantages structurels.
Le premier réside dans la maturité de son écosystème logiciel.
CUDA bénéficie de nombreuses années de développement, d’optimisation et d’adoption.
Les bibliothèques spécialisées, les outils de profilage et les mécanismes de communication entre GPU constituent un ensemble difficile à reproduire rapidement.
Le deuxième avantage concerne l’intégration des systèmes.
Les performances des infrastructures modernes ne dépendent pas uniquement de chaque processeur pris isolément.
Elles reposent également sur les interconnexions, la mémoire, les réseaux et les logiciels capables de coordonner des milliers d’accélérateurs.
Nvidia a progressivement étendu son activité à ces différentes composantes.
Le troisième avantage tient à la confiance opérationnelle.
Les grandes entreprises qui exploitent des modèles critiques privilégient souvent des architectures dont les performances et la fiabilité ont été éprouvées à grande échelle.
Même lorsqu’une alternative présente un avantage économique théorique, son adoption peut être retardée par les exigences de validation.
Enfin, Nvidia bénéficie d’une position particulièrement forte auprès des développeurs et des entreprises spécialisées dans les modèles les plus avancés.
Les innovations logicielles apparaissent fréquemment en priorité dans les environnements disposant des ressources matérielles les plus répandues.
Cette dynamique continue d’alimenter l’attractivité de son écosystème.
TorchNeuron ne supprime donc pas la domination de Nvidia.
Il cherche à en réduire l’une des sources.
La différence est importante : contester une barrière à l’entrée ne signifie pas immédiatement conquérir les parts de marché qu’elle protège.
X. Une bataille industrielle qui dépasse les semi-conducteurs
La confrontation entre Amazon et Nvidia possède également une dimension macroéconomique.
L’intelligence artificielle est devenue un moteur majeur des investissements dans les infrastructures numériques.
La construction de centres de données mobilise des capitaux considérables, des équipements électriques, des systèmes de refroidissement, des réseaux de communication et des chaînes d’approvisionnement mondiales.
La disponibilité des accélérateurs constitue l’un des facteurs de cette expansion.
Mais leur coût n’est qu’une composante de l’équation.
L’accès à l’électricité, la capacité des réseaux, les délais de construction et les contraintes environnementales influencent également la rentabilité des projets.
Dans ce contexte, l’amélioration de l’efficacité économique du calcul peut produire des effets au-delà du secteur des semi-conducteurs.
Si une architecture permet de réaliser davantage de travail utile avec une quantité donnée de ressources, elle peut améliorer la rentabilité des infrastructures existantes.
Elle peut aussi modifier les arbitrages d’investissement entre nouveaux centres de données et optimisation des capacités installées.
Il faut néanmoins distinguer efficacité et réduction absolue de la consommation.
Une baisse du coût du calcul peut encourager une utilisation plus intensive de l’intelligence artificielle.
L’augmentation de la demande peut alors absorber une partie, voire la totalité, des gains d’efficacité.
Ce phénomène, proche de l’effet rebond observé dans d’autres industries, constitue une variable importante de l’économie énergétique de l’IA.
La concurrence entre accélérateurs pourrait ainsi contribuer simultanément à réduire le coût unitaire du calcul et à accélérer l’expansion globale des infrastructures.
L’enjeu industriel ne se limite donc pas à savoir qui vendra les processeurs.
Il concerne la manière dont les gains de productivité informatique se diffuseront dans l’économie réelle.
XI. Trois trajectoires possibles pour le marché des accélérateurs
À moyen terme, plusieurs évolutions sont envisageables.
Premier scénario : Nvidia conserve une domination structurelle.
Les alternatives progressent, mais les avantages logiciels, les performances systèmes et les habitudes de développement continuent de favoriser Nvidia.
Trainium trouve sa place sur certaines charges de travail sans transformer profondément la structure du marché.
Amazon améliore ses marges sur certaines infrastructures, mais Nvidia conserve son rôle central dans le calcul avancé.
Deuxième scénario : un marché multipolaire se constitue.
La portabilité logicielle progresse.
Les entreprises utilisent plusieurs architectures selon leurs besoins.
Nvidia conserve un rôle central dans certains segments, tandis qu’Amazon, Google et AMD gagnent du terrain dans d’autres.
Les décisions d’infrastructure reposent davantage sur des comparaisons économiques entre plateformes.
La concurrence se déplace progressivement vers les coûts d’exploitation et la qualité des environnements logiciels.
Troisième scénario : les géants du cloud captent une part croissante de la valeur.
Les architectures propriétaires deviennent suffisamment compétitives pour une part importante des applications.
Les grands opérateurs cloud internalisent davantage de conception matérielle et renforcent leur contrôle sur l’économie du calcul.
Dans cette configuration, la concurrence ne disparaît pas.
Elle se réorganise autour de plateformes intégrées, capables de contrôler simultanément les processeurs, les logiciels et la distribution des capacités informatiques.
Ces scénarios ne sont pas mutuellement exclusifs.
Nvidia pourrait conserver une position dominante sur les systèmes les plus avancés tandis que les processeurs propriétaires des opérateurs cloud se développeraient rapidement dans l’inférence.
Le marché pourrait ainsi connaître une segmentation croissante plutôt qu’un remplacement brutal du fournisseur dominant.
Cette évolution serait cohérente avec l’histoire d’autres industries technologiques, dans lesquelles les architectures généralistes ont progressivement coexisté avec des solutions spécialisées.
La variable déterminante restera le coût total d’exploitation.
Un processeur ne sera compétitif que si ses avantages matériels peuvent être exploités à travers un environnement logiciel suffisamment stable, accessible et performant.
XII. Les indicateurs qui permettront de mesurer la réussite d’Amazon
L’annonce de TorchNeuron marque une étape, mais elle ne permet pas encore de conclure à une transformation du marché.
Plusieurs indicateurs devront être observés au cours des prochains trimestres.
Le premier sera l’adoption effective de TorchNeuron par les développeurs et les entreprises.
Le nombre d’expérimentations importe moins que celui des applications exploitées durablement en production.
Le deuxième sera l’étendue de la compatibilité.
L’enjeu sera de déterminer si les modèles récents, les bibliothèques spécialisées et les nouvelles méthodes d’optimisation peuvent fonctionner sur Trainium sans adaptations disproportionnées.
Le troisième sera la compétitivité économique mesurée sur des charges de travail comparables.
Les benchmarks devront intégrer non seulement le prix des instances, mais aussi le débit réel, les performances, les coûts de migration et les ressources d’ingénierie nécessaires.
Le quatrième sera la capacité d’Amazon à maintenir son logiciel au rythme des évolutions de PyTorch.
L’écosystème de l’intelligence artificielle évolue rapidement. Une compatibilité satisfaisante aujourd’hui peut devenir insuffisante si les nouveaux modèles et outils ne sont pas pris en charge rapidement.
Enfin, il faudra observer la réaction de Nvidia.
L’entreprise peut répondre à cette concurrence par de nouvelles optimisations logicielles, des améliorations matérielles, des offres économiques plus attractives ou un renforcement de son intégration avec les fournisseurs cloud.
La dynamique concurrentielle dépendra donc autant des progrès d’Amazon que des capacités d’adaptation du fournisseur dominant.
Conclusion — La bataille de l’IA entre dans l’ère de la portabilité
L’annonce de TorchNeuron ne constitue pas une rupture immédiate dans la domination industrielle de Nvidia.
Elle révèle néanmoins une évolution stratégique importante.
Pendant plusieurs années, la puissance des accélérateurs a été l’un des principaux facteurs de différenciation du marché de l’intelligence artificielle.
Cette puissance reste essentielle, mais elle ne suffit plus à expliquer les rapports de force.
Les logiciels, les coûts de migration, la disponibilité des infrastructures et l’intégration des services cloud deviennent des éléments centraux de la concurrence.
Amazon l’a compris.
En facilitant l’exécution de PyTorch sur Trainium, AWS cherche à affaiblir le lien historique entre le développement des modèles et l’utilisation des processeurs Nvidia.
La réussite de cette stratégie n’est pas garantie.
Elle dépendra de la maturité des outils, des performances réelles, de l’adoption par les développeurs et de la capacité d’Amazon à proposer une alternative économiquement crédible.
Mais le mouvement industriel est déjà perceptible.
Les grands opérateurs cloud ne souhaitent plus dépendre exclusivement des fabricants de semi-conducteurs pour définir le coût et les capacités de leurs infrastructures.
Ils veulent concevoir leurs propres architectures, contrôler davantage leur chaîne de valeur et offrir aux développeurs des environnements suffisamment familiers pour encourager leur adoption.
La conséquence pourrait être une transformation progressive du marché des accélérateurs, passant d’une domination largement structurée autour d’un écosystème à une concurrence entre plusieurs plateformes intégrées.
Cette évolution ne signifie pas nécessairement la fin de la puissance de Nvidia.
Elle pourrait en revanche modifier les conditions dans lesquelles cette puissance s’exerce.
Le véritable enjeu de TorchNeuron n’est pas de démontrer qu’Amazon sait fabriquer des processeurs concurrents. Il est de déterminer si Nvidia pourra continuer à bénéficier d’un avantage logiciel aussi décisif lorsque les applications d’intelligence artificielle deviendront plus facilement transférables d’une architecture à une autre.
Dans l’industrie de l’IA, la prochaine bataille ne se jouera pas seulement sur la puissance des puces.
Elle se jouera sur la liberté — réelle ou apparente — de choisir celles qui exécutent les logiciels.
Sources et références
- PyTorch, Introducing TorchNeuron: Native PyTorch Backend for AWS Trainium, 19 octobre 2026. https://pytorch.org/blog/introducing-torchneuron-native-pytorch-backend-for-aws-trainium/
- Amazon Web Services, How Deepgram Optimized Voice AI at Scale with AWS Trainium, 19 octobre 2026. https://aws.amazon.com/blogs/machine-learning/how-deepgram-optimized-voice-ai-at-scale-with-aws-trainium/
- Hugging Face, TorchNeuron: Running HF Models on AWS Trainium, octobre 2026. https://huggingface.co/blog/hf-torchneuron
- Reuters, Amazon Challenges Nvidia with PyTorch-Compatible AI Chips, 19 octobre 2026.
- AWS Neuron, documentation technique TorchNeuron. https://awsdocs-neuron.readthedocs-hosted.com/en/latest/release-notes/components/torchneuron.html
Atlas Limits — Analyse technologique, économique et industrielle.
Bureau de recherche Atlas Limits
Bureau éditorial et analytique d’Atlas Limits.